Reo Brain : le cœur intelligent que nous construisons chez Reotech
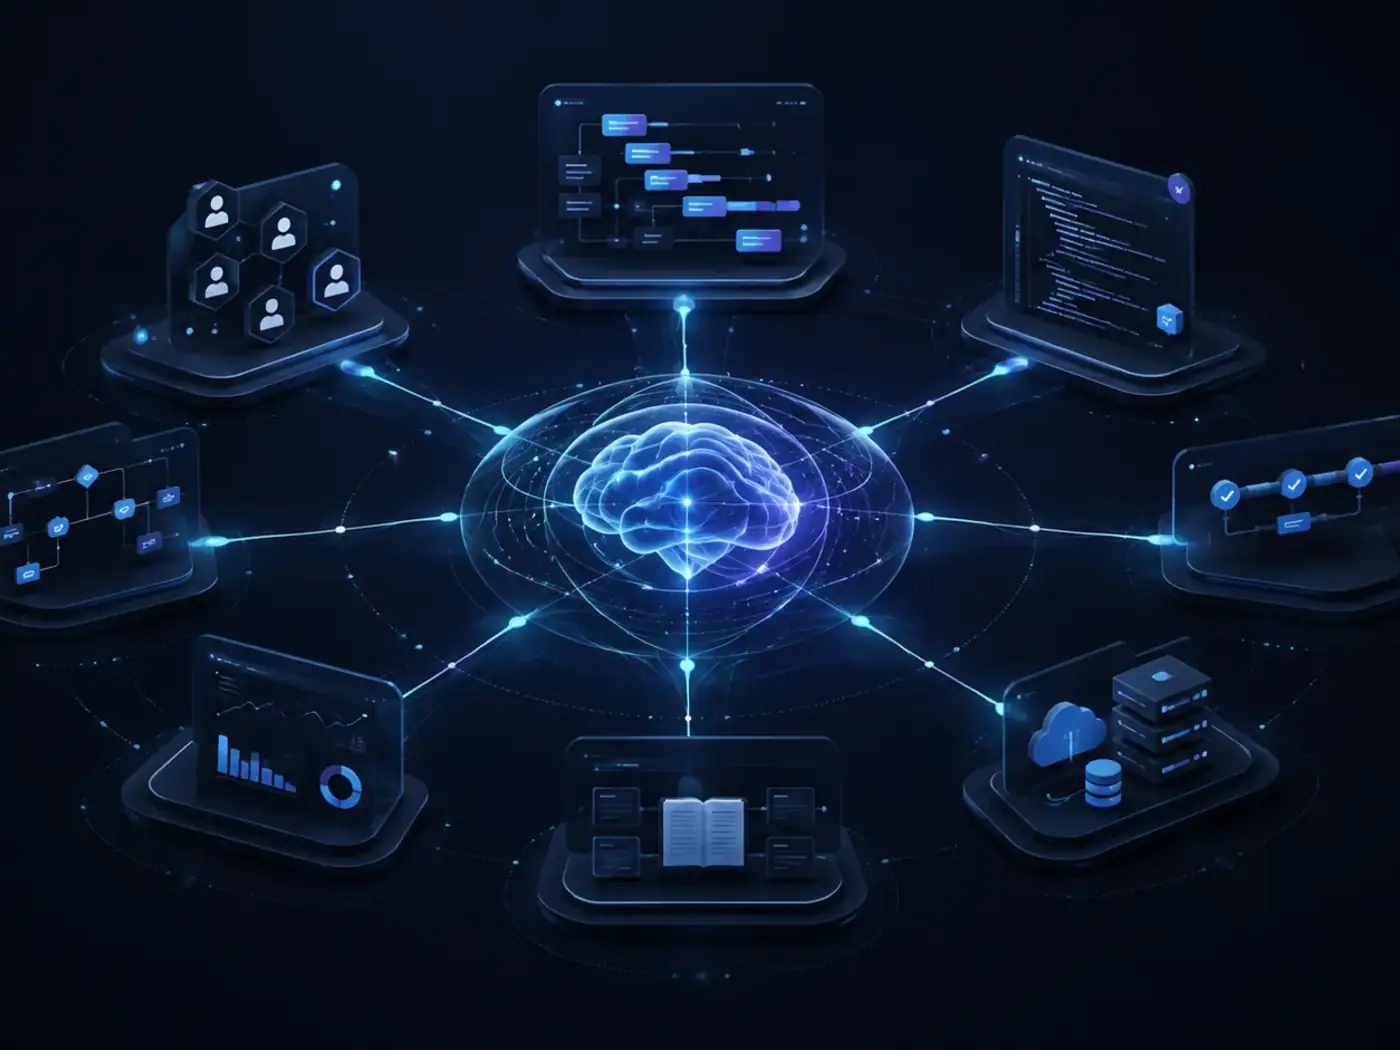
Reo Brain est la couche opérationnelle agentique interne de Reotech : un système local-first qui relie projets, code, CI/CD, infrastructure, connaissances de l'entreprise, observabilité et agents IA spécialisés dans une même boucle de livraison.
- Client Reotech
- Secteur Plateforme interne et infrastructure IA
- Publication juillet 2026
- Systèmes d'agents IA
- Opérations assistées par l'IA
- Outils internes
- Architecture logicielle
- DevOps et automatisation
Les décisions, le développement, les revues, les tests, les mises en production et les incidents peuvent partager le même contexte.
Les informations sensibles sur Reotech et ses clients peuvent être traitées sur notre propre infrastructure.
Les agents enquêtent et proposent. Les permissions et validations humaines encadrent ce qu'ils peuvent réellement faire.
- TypeScript
- Modèles de langage locaux
- OMLX
- Plane
- Forgejo
- GitHub
- Trigger.dev
- PostgreSQL
- Qdrant
- Docker
- Langfuse
Le problème
Beaucoup d’outils d’IA en entreprise commencent par une fenêtre de discussion : on connecte un modèle, on ajoute des documents, on pose des questions. C’est pratique, mais ce n’était pas le problème que nous voulions résoudre chez Reotech.
Notre vrai problème n’était pas l’accès à l’information. Nous avions déjà l’information — dispersée entre sept systèmes qui ne s’étaient jamais présentés les uns aux autres.
- Plane
- Forgejo / GitHub
- Tests
- Déploiements
- Suivi en production
- Infrastructure
- Reo Brain
Une demande client, le travail qui a suivi, l’implémentation, le passage des tests, le déploiement et le comportement en production vivaient dans des outils différents. Une personne peut relier ces éléments. Un logiciel ne le fait pas tout seul. Et une conversation avec une IA encore moins — sauf si quelqu’un lui réexplique l’entreprise à chaque fois, dix minutes, systématiquement.
Reo Brain est notre tentative de rendre l’entreprise elle-même compréhensible par l’IA — non pas en remplaçant nos outils par une application monolithique, mais en créant une couche d’intelligence et d’orchestration entre eux.
Pourquoi une simple conversation ne suffisait pas
D’un assistant IA à un cœur intelligent d’entreprise
La première idée était modeste : organiser les notes d’un projet, retrouver un travail similaire et préparer un premier brouillon technique pour que l’ingénieur ne parte pas d’une page blanche.
C’est utile. Mais dès que nous avons connecté l’IA à de vrais systèmes, une question bien plus intéressante est apparue :
Et si l’IA comprenait ce qui se passe dans l’entreprise sans attendre qu’on lui demande ?
L’ouverture d’une demande de revue de code n’est jamais une simple notification Git. Elle signifie qu’un travail est peut-être prêt. Si la revue demande des corrections, ce travail réclame de l’attention. Si les tests échouent, la fonctionnalité n’est pas prête. Et si tout passe, si la mise en production provoque trois semaines plus tard un incident, cet incident est relié au déploiement, qui est relié à la revue, qui est relié à la tâche, qui est relié au besoin initial et à la décision du client.
Aujourd’hui, ce sont les humains qui portent ces relations dans leur tête. Reo Brain est conçu pour les porter dans le système.
Une couche opérationnelle, des outils existants
Nous ne cherchons pas à recréer GitHub, Plane, la surveillance ou l’intégration continue dans un produit d’IA. Chaque outil garde son rôle. Plane suit le travail. Forgejo et GitHub gèrent le code et la collaboration. Les runners d’intégration continue construisent et testent. Trigger.dev exécute les tâches longues. Notre infrastructure fait tourner applications et services internes, la surveillance les observe, PostgreSQL conserve les données structurées, Qdrant retrouve une connaissance quand une relation simple ne suffit pas, et les modèles locaux raisonnent quand les règles seules ne suffisent plus.
Reo Brain se place au-dessus de ces systèmes. Son rôle : comprendre ce qui s’est passé, à quoi cela appartient, ce que cela signifie et ce qui devrait suivre.
C’est cette distinction qui a transformé Reo Brain d’une fonctionnalité IA en plateforme interne.
Ce qui tourne aujourd’hui — et ce qui reste à construire
La plupart des études de cas gomment cette partie ; soyons précis plutôt : Reo Brain est une construction active, et prétendre le contraire dénaturerait le projet.
En production aujourd’hui
Le socle, c’est une infrastructure que nous utilisons chaque jour :
- des compute locaux exécutant l’inférence via OMLX sur du matériel que nous contrôlons ;
- une forge privée avec Forgejo — GitHub quand un projet client l’exige — et des runners d’intégration continue dédiés ;
- Trigger.dev pour les workflows durables, PostgreSQL pour l’état opérationnel structuré, Qdrant pour la recherche sémantique ;
- Langfuse qui trace la couche IA elle-même, en complément de l’observabilité applicative classique.
Sur ce socle fonctionnent des flux d’ingénierie connectés et les premiers agents spécialisés — chacun avec un périmètre borné, son propre contexte et des règles explicites plutôt qu’un accès illimité à tout.
En construction maintenant
La phase actuelle est la plus difficile : la couche opérationnelle partagée qui transforme des capacités isolées en un système unique — le pipeline d’événements unifié, le graphe de contexte et de connaissances, l’orchestration des agents, les outils et permissions, et la boucle d’évaluation qui nous dit si un agent s’est réellement amélioré ou a simplement produit une meilleure démo.
Très probablement, les proportions entre « en production » et « en construction » seront très différentes dans six mois. Écrire le plan quand même, c’est ainsi que nous nous y tenons.
Comment nous le construisons
Des agents spécialisés, pas une IA avec accès à tout
Le moyen le plus simple de construire un système d’IA dangereux, c’est de créer un agent géant et de lui donner tous les outils. Nous avons pris le chemin inverse : Reo Brain s’organise autour d’agents spécialisés aux responsabilités explicites.
L’agent chargé de l’infrastructure connaît les serveurs, le réseau, le stockage, les conteneurs, le DNS, les déploiements, la surveillance et nos standards opérationnels. Il n’a pas besoin de lire toutes les conversations commerciales. L’agent d’ingénierie peut consulter le code, l’architecture des dépôts, les tests, les résultats d’intégration continue, les standards techniques et les demandes de revue. L’agent de planification a besoin des objectifs, décisions historiques, dépendances, estimations précédentes et patterns d’implémentation.
L’important, c’est qu’ils n’existent pas comme des chatbots sans lien entre eux. Ils partagent une couche opérationnelle. Ils reçoivent le bon contexte, utilisent des outils autorisés, confient le travail à des workflows déterministes, demandent une décision humaine — et chacune de leurs actions remonte à l’événement et à l’information qui l’a déclenchée.
L’IA seulement là où elle sert vraiment
Devenir « agentique » ne signifie pas demander à un LLM de piloter chaque étape. Si une revue de code est approuvée, aucun logiciel n’a besoin d’intelligence artificielle pour changer le statut d’une tâche — c’est un événement déterministe, donc nous l’automatisons normalement.
L’IA devient utile quand l’étape suivante exige une interprétation : pourquoi les tests ont-ils échoué ? Cette implémentation répond-elle vraiment au besoin ? Cet incident vient-il du déploiement d’hier ? Deux demandes se contredisent-elles ? Faut-il escalader vers un humain ?
Cette séparation est fondamentale pour l’architecture. Le logiciel classique exécute les règles connues. L’IA traite ce qui demande une interprétation. Elle rend le système moins coûteux, plus rapide, plus facile à tester et bien plus sûr que de placer un modèle au milieu de chaque opération.
Un pipeline déclenché par les événements
Plutôt qu’une personne qui sollicite un assistant en continu, Reo Brain écoute les signaux que l’entreprise produit déjà — demandes qui changent, branches créées, revues qui demandent des corrections, tests qui échouent ou passent, déploiements livrés ou cassés, surveillance qui détecte une anomalie, nouvelles connaissances opérationnelles.
Ces événements entrent dans des workflows qui les valident, les normalisent, les enrichissent et les rattachent aux entités connues. Seul le moment où un raisonnement est requis mobilise la capacité d’IA appropriée. Le travail long traverse une orchestration durable au lieu de reposer sur une requête HTTP unique ou sur un agent qui resterait en vie indéfiniment.
- 01
Signal
Un événement arrive : une demande change, un test échoue, un déploiement part, la production signale une anomalie.
- Plane
- Forgejo / GitHub
- Tests
- Surveillance
- 02
Contexte
Le système rattache l'événement au bon projet, à la bonne tâche, au dépôt et à son historique.
- PostgreSQL
- Graphe d'événements
- 03
Analyse
Un modèle intervient seulement si la situation doit être expliquée ou classée.
- Modèles locaux
- OMLX
- 04
Plan
L'agent propose une explication, une correction, une mise à jour ou une alerte.
- Agents spécialisés
- 05
Action
Les actions simples et peu risquées passent par des outils et des règles connues.
- Trigger.dev
- Outils internes
- 06
Vérification
Le système conserve la décision, les outils utilisés et leur résultat pour pouvoir les contrôler.
- Langfuse
- Suivi technique
- 07
Mémoire
Le résultat rejoint la connaissance de l'entreprise pour la prochaine situation similaire.
- Qdrant
- Base de connaissances
Pas « prompt → modèle → on croise les doigts ». L'analyse est la seule étape qui appelle un modèle, et seulement quand l'étape suivante exige une interprétation.
L’accès n’est pas l’autorité
Pour participer à une entreprise, produire du texte ne suffit pas — un agent a besoin de capacités. Selon son rôle, un agent Reo Brain peut lire l’état d’un projet dans Plane, consulter l’historique d’une tâche, inspecter un dépôt, chercher dans la documentation technique, retrouver une décision ancienne, examiner une demande de revue, lire les journaux de tests, vérifier l’état d’un déploiement, interroger la surveillance, créer ou mettre à jour une information interne structurée, lancer un workflow prédéfini, préparer une proposition de modification, ou demander à un humain d’approuver une action sensible. Nous explorons MCP, parallèlement aux API natives et services internes, comme moyens d’exposer ces capacités via des contrats clairs.
Mais l’accès n’est pas automatiquement l’autorité. Qu’un agent soit techniquement capable d’effectuer une opération ne signifie pas qu’il doive pouvoir la faire.
Raisonnement, outillage, permissions et approbation sont des couches séparées. Cela permet d’automatiser avec agressivité là où le risque est faible, sans appliquer la même politique aux changements en production, aux opérations destructrices ou aux décisions sensibles des clients.
Une mémoire liée aux faits
Un agent utile ne devrait pas redécouvrir Reotech chaque matin. Mais entasser des milliers de documents dans un prompt n’est pas davantage de l’intelligence.
Reo Brain sépare les types de mémoire. L’information structurée — projets, environnements, dépôts, tâches, responsabilités, événements, déploiements, exécutions d’agents et leurs relations — appartient aux systèmes structurés où elle peut être représentée explicitement. La connaissance longue — documents d’architecture, spécifications, runbooks opérationnels, notes d’infrastructure, incidents passés, décisions d’implémentation, enseignements des projets terminés — demande une recherche sémantique capable de faire remonter un petit ensemble pertinent au moment utile.
L’objectif n’est volontairement pas « donner au modèle tout ce que nous savons ». C’est :
donner au modèle le plus petit ensemble d’informations fiables nécessaire pour bien prendre cette décision.
Plus de contexte n’est pas forcément un meilleur contexte. Un contexte restreint mais bien choisi peut surpasser un prompt énorme rempli d’historique sans rapport.
Une IA locale comme partie de notre infrastructure
Une partie des informations les plus précieuses auxquelles Reo Brain accède figure aussi parmi celles que nous voulons le moins envoyer sans discernement hors de l’entreprise : besoins clients, code source, architecture interne, incidents, décisions commerciales, travaux réalisés sous accord de confidentialité.
Voilà pourquoi l’IA locale n’est pas pour nous une case marketing — c’est un choix d’architecture. Reotech exploite sa propre infrastructure de modèles, notamment l’inférence via OMLX sur nos propres machines.
Local-first ne veut pas dire non plus tout faire passer par un modèle unique et gigantesque. Les tâches ont des exigences différentes : un petit modèle suffit à classer ou router un événement, un autre gère l’extraction structurée, un modèle avec vision traite documents ou captures d’écran, et un modèle de raisonnement plus puissant ne mérite son coût que sur une investigation technique difficile. Beaucoup de workflows ne devraient jamais appeler un modèle. Quand un modèle externe se justifie et que la politique de données le permet, cela reste une capacité explicite plutôt qu’une dépendance architecturale.
Comment il se comporte
Une trace concrète
Les schémas d’architecture cachent toujours le moment intéressant. Voici donc la forme d’une enquête : une demande de revue s’ouvre dans Forgejo, le pipeline la relie à son projet et à sa tâche, les tests échouent, et l’agent d’ingénierie commence à investiguer sans qu’on le lui demande.
- event pull_request.opened auth-service · feature/sso-refresh → main
- context contexte assemblé tâche liée, besoin, historique du dépôt, décisions antérieures
- event ci.failed 3 tests en échec dans le middleware de session
- agent agent d'ingénierie mobilisé lit les journaux d'échec, fichiers modifiés, sorties de tests, besoin initial
- action explication proposée régression de cookie de session — cause probable + correction suggérée
- result tâche mise à jour statut → corrections demandées, cause racine attachée
Personne n'a eu besoin de lancer l'enquête. L'échec des tests a suffi.
Résultat : le projet cesse d’être une collection d’écrans déconnectés et devient un graphique opérationnel vivant de ce que fait l’entreprise — où un problème ultérieur se remonte à rebours à travers les décisions qui l’ont produit, au lieu de vivre uniquement dans la mémoire de celui qui s’en souvient.
C’est d’ailleurs la vraie chose que nous automatisons. Pas les ingénieurs — le travail de coordination qui les entoure : les vérifications répétées, la collecte de contexte, la synchronisation des statuts, la recherche dans les vieilles décisions, le travail manuel nécessaire simplement pour comprendre l’état actuel de quelque chose. Cela libère du temps pour le travail où le jugement compte : architecture, décisions produit, communication client, débogage difficile, arbitrages, construction.
Voir ce que font les agents
La surveillance classique demande si la requête a réussi, combien de temps elle a pris, quel service a échoué. Les systèmes agentiques ajoutent une catégorie entière : que savait l’agent avant d’agir ? Quels documents ont été retrouvés ? Quel modèle a décidé, quels outils a-t-il appelés, qu’ont-ils renvoyé ? A-t-il réessayé ? Une validation humaine était-elle requise, et la recommandation a-t-elle été acceptée ?
Si un système d’IA participe à de vraies opérations, ces détails ne peuvent pas disparaître dans une boîte noire. Nous utilisons un tracing et une évaluation propres à l’IA, à côté de l’observabilité applicative normale, pour que le comportement des agents puisse être inspecté et amélioré.
Les modèles changent. Les prompts changent. La récupération et les outils changent. Le système a donc besoin d’évaluation comme un logiciel classique a besoin de tests — l’objectif est d’améliorer un agent parce que les preuves montrent qu’il s’améliore, pas parce qu’un nouveau modèle produit une démo plus impressionnante.
Le contrôle humain fait partie du système
Agentique ne signifie pas autonome par défaut. Nous classons les actions selon leur conséquence : lire des journaux de tests est peu risqué, proposer la cause probable d’un échec le reste presque autant, mettre à jour une tâche après un événement certain du dépôt peut rester déterministe. Mais préparer un changement de code est différent de le fusionner. Recommander un changement d’infrastructure est différent de l’exécuter. Redémarrer une charge interne sûre est différent de modifier le réseau de production.
Le travail peu risqué disparaît dans l’automatisation. Le travail plus risqué aboutit à une proposition. Le travail critique exige une décision humaine explicite. Chaque catégorie profite quand même d’un meilleur contexte et d’une analyse plus rapide.
L’objectif, c’est l’autonomie contrôlée, pas l’autonomie maximale.
L’architecture
L’infrastructure derrière l’idée
La couche d’agents ne fonctionne que parce qu’elle repose sur une véritable infrastructure opérationnelle. Reotech exploite son propre environnement de développement et de serveurs — Forgejo avec support GitHub quand nécessaire, runners d’intégration continue dédiés, registre de conteneurs privé, et serveurs séparant réseau, applications, stockage et surveillance.
Outils existants
Chaque outil garde son rôle.
- Plane
- Forgejo / GitHub
- Runners de tests
- Trigger.dev
- Infrastructure & surveillance
Noyau Reo Brain
Comprend ce qui s'est passé, ce que cela signifie, ce qui devrait suivre.
- Pipeline d'événements
- Graphe de contexte & connaissances
- Orchestration des agents
- Outils & permissions
- Observabilité & évaluation
Couche modèles
Choisi par tâche, pas par plateforme.
- Inférence locale via OMLX
- Routage par tâche
- Modèles externes si permis
Reo Brain ne remplace pas cette pile — il la traverse, pour que chaque outil conserve son rôle.
Reo Brain ne remplace pas ces systèmes. Il les relie en quelque chose de plus utile que la somme de leurs tableaux de bord.
La suite
- Phase 1
Fondation IA locale
Construction des fondations de modèles locaux et d'infrastructure nécessaires pour exécuter les flux d'IA des opérations sur des systèmes contrôlés par Reotech.
- Phase 2
Flux d'ingénierie connectés
Connexion d'une plus grande partie du cycle d'ingénierie : projets, dépôts, tests, déploiements, connaissances internes et services opérationnels.
- Phase 3
Agents spécialisés
Passage des assistants génériques à des agents bornés, avec responsabilités, contexte, outils et règles de fonctionnement spécifiques.
- En cours
Couche opérationnelle agentique
Construction des couches partagées — événements, contexte, orchestration, connaissances, observabilité, permissions — qui permettent aux agents et services de fonctionner comme un seul système d'entreprise.
Un système qui s’améliore à mesure que l’entreprise fonctionne
La dernière pièce de l’architecture, c’est la boucle de retour :
- Un projet terminé crée de la connaissance utile.
- Un incident crée de la connaissance utile.
- Une recommandation IA corrigée crée de la connaissance utile.
- Un plan rejeté crée de la connaissance utile.
- L’issue d’un déploiement crée de la connaissance utile.
- Une décision humaine crée de la connaissance utile.
Cela ne veut pas dire laisser un modèle réécrire sa propre mémoire chaque fois qu’il produit une réponse. La connaissance utile a besoin de provenance — nous devons savoir si elle vient d’un système faisant autorité, d’une décision humaine, d’un événement observé, d’une documentation retrouvée ou d’une inférence IA.
La valeur à long terme de Reo Brain, c’est que le système opérationnel s’enrichit à mesure que Reotech travaille : le prochain projet bénéficie du précédent, le prochain incident bénéficie de la résolution du similaire, et les agents démarrent avec un vrai contexte d’entreprise plutôt qu’une connaissance générique.
Pourquoi construire tout cela en interne ?
Parce que c’est aussi ainsi que nous voulons construire l’IA pour nos clients.
- Pas un chatbot branché sur une base de données.
- Pas une collection de prompts.
- Pas un badge « propulsé par l’IA » ajouté à une page produit.
Ce qui nous intéresse, ce sont des systèmes où l’IA comprend les opérations spécifiques d’une activité et travaille aux côtés des logiciels qui la font déjà tourner. Pour une entreprise de logistique, comprendre livraisons, chauffeurs, exceptions, documents, véhicules et workflows opérationnels. Pour un produit financier, comprendre documents, transactions, contrats, engagements récurrents et rapprochements, en gardant les règles financières déterministes hors du modèle. Pour une autre entreprise, le cœur pourrait ressembler à tout autre chose — l’architecture s’adapte parce que les opérations de l’entreprise en deviennent le fondement.
Reo Brain, c’est là où nous construisons et opérons ces idées sur nous-mêmes d’abord.
Le résultat
Reo Brain a commencé comme un moyen de rendre notre propre flux d’ingénierie plus intelligent.
Il devient quelque chose de plus grand : une couche d’intelligence partagée à travers l’entreprise.
- Les projets connaissent le code.
- Le code connaît le travail.
- Les tests alimentent l’état de livraison.
- Les déploiements nourrissent les opérations.
- Les événements opérationnels peuvent atteindre les agents spécialisés.
- Les agents peuvent retrouver la connaissance de l’entreprise et utiliser des outils contrôlés.
- Les actions routinières peuvent se produire automatiquement.
- Les situations ambiguës peuvent être investiguées.
- Les décisions sensibles peuvent s’arrêter à une frontière d’approbation humaine.
Et l’historique généré par tout ce processus peut devenir le contexte utile de ce qui suivra.
Pour une personne non technique, l’idée est simple : moins de temps à coordonner des logiciels, plus de temps à faire un travail utile.
Pour nous, techniquement, le défi intéressant est de tenir cette promesse sans créer une boîte noire d’IA incontrôlable — combiner logiciel piloté par événements, workflows durables, inférence locale, données structurées, recherche sémantique, agents spécialisés, outils explicites, permissions, observabilité, évaluation et approbation humaine en un seul système.
C’est ce que Reo Brain est en train de devenir.
Et avant de construire ce type d’infrastructure pour l’entreprise de quelqu’un d’autre, nous voulons qu’elle fasse tourner la nôtre.
Construisons votre prochain outil.
Découvrez le type de problème résolu par ce projet.